何恺明团队的新论文,在X上炸了!
十一手艺刚挂上arXiv的VISTA论文清楚,往日半年,全天下最顶尖的大模子,全是被「蒙着眼睛」赶上AGI科场的。
归拢个Claude Opus 5,在官方模范测试里只拿了怜悯的40分。
何恺明团队只不外帮它摘掉了眼罩,让它亲眼看游戏画面,顺遂递给它一册能随时往回翻的「相册」。
服从,Claude径直把ARC-AGI-3的25个公开游戏全部打穿,拿下100分满分!
况兼它走的步数,致使比第一次玩的东谈主类还少了一半多。
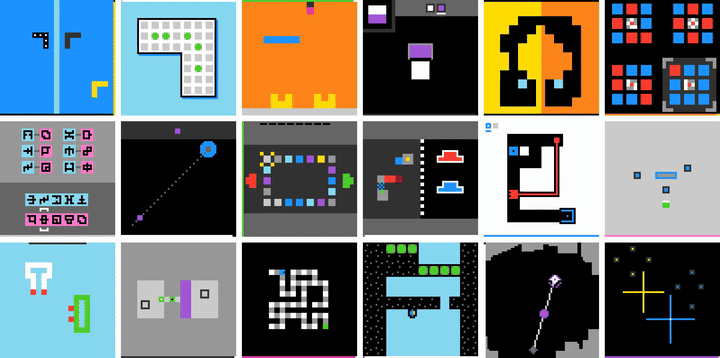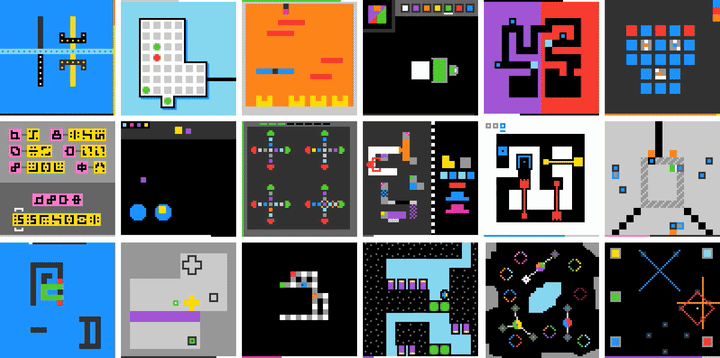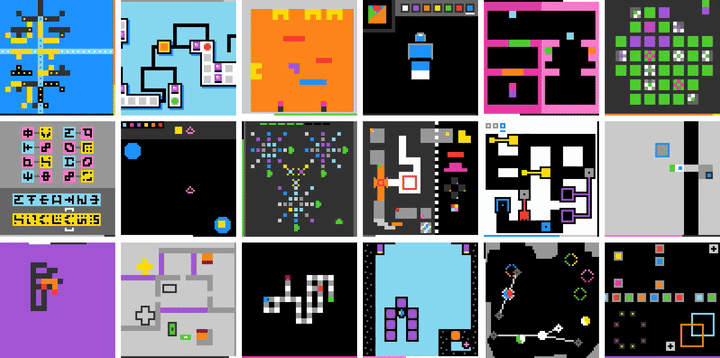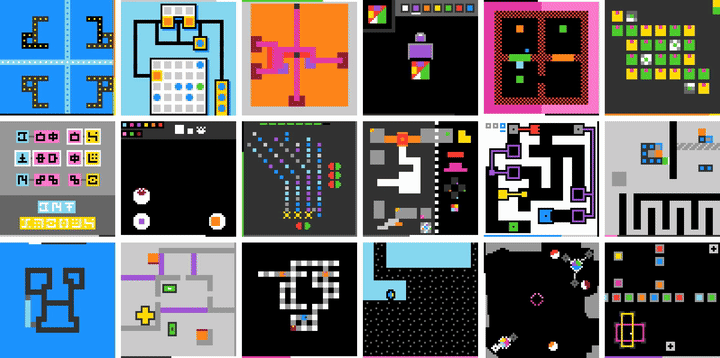
18个从没见过的游戏,没东谈主给它一句确认,AI我方摸清规定沿路通关
驰名AI博主Mark Kretschmann在X上写谈:「给Agent一个『再看一眼』的才调,辩认可能格外大。」
往日几个月,为了打穿ARC-AGI-3,各路代码大神写了几千行代码搞天下模拟器。
何恺明团队的判断是,大模子的脑子早就够用了,卡住它的,是眼睛和记性。
大模子被一张数字表,坑了半年
ARC-AGI-3,是Keras之父François Chollet和ARC Prize基金会本年3月出的AGI考卷。一堆交互式像素小游戏,开局莫得任何确认和规定,全靠玩家我方摸索试错。
分数算法极其严苛。官方找来近500名东谈主类小白实测,AI不光要通关,步数还不可比东谈主类多,才调拿满分。
可官方科场递给大模子的,仅仅一张64×64的数字表。东谈主类看到的庸东谈主、机关和道路,到了模子那儿只剩4096个数字。
这格外于让东谈主闭着眼,听别东谈主报坐标去玩《超等马里奥》。
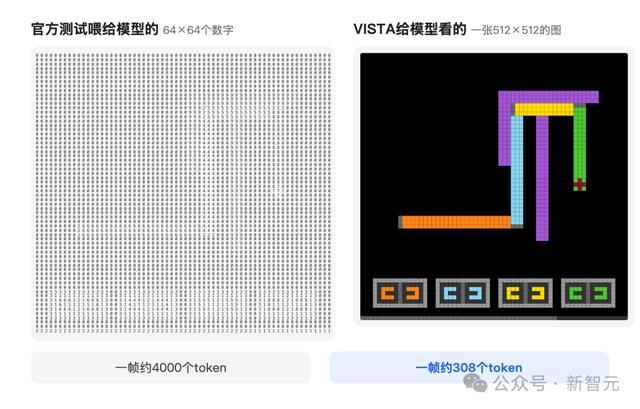
归拢帧画面,左边是官方递给模子的数字表,右边是VISTA让它径直看的图
VISTA团队作念的第一件事,便是把数字表换回图片。
别的什么王人没改,GPT-5.6 Sol的分数就从13.33分跳到了47.32分。
看图还更省算力。一个数字格子要吃掉约4000个Token,一张512×512的图片只须308个。
一局跑下来,文本版烧掉7190万Token,图片版只须3070万,分数还更高。
光是换上一对信得过的眼睛,大模子就捡回了34分。
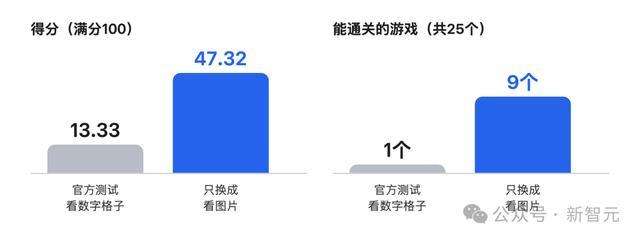
只把数字换成图片,GPT-5.6 Sol的分数涨了三倍多,能通关的游戏从1个形成9个
让AI过目不忘,一步多拿24分
光能看见还不够。一局游戏动辄几百步,多模态模子的通病是:图片看一遍,险阻文一满就删,梗概压缩成几句笔墨撮要。
等模子想回头查对细节时,那一帧早就化为乌有了。
VISTA的中枢杀招,便是一册无损视觉操心「相册」。
游戏吐出的每一帧画面,连动画帧在内,全按编号原样归档。模子想看哪一帧,随时调用inspect翻出来,几帧并列对比、边缘放多数行,还能用read_pixels读出精准心情。
最垂死的是,翻相册不算步数,惟有真在游戏里操作才计步。
团队把这套机制叫作「显式雅致力」,翻哪一帧、看哪一块,全由模子我方说了算。
它还随身带着两个条记本,GUIDE.md记游戏规定,WORKING.md当草稿纸。
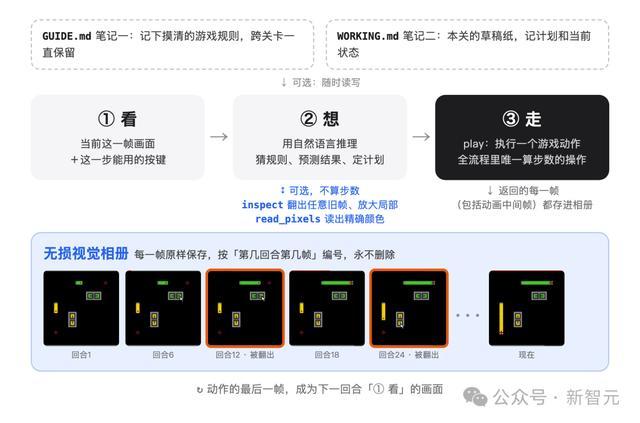
VISTA的一个回合,模子看画面、想规定,需要时翻相册,终末才走一步
论文里记载了一个十分「像东谈主」的操作遽然。
在BP35游戏第3关,画面出现了一个橙色方块。模子点了一下,橙块形成了X。
它先停了下来,把上一趟合的终末一帧和刚才的三帧动画调出来,并列回放。
几回合后,它又发现点X能让橙块从头长出来,就地写谈:「这便是我要的器具,用它搭天花板,挡住会要命的飞腾。」
这一关,第一次玩的东谈主类要走44步,它只用了34步。
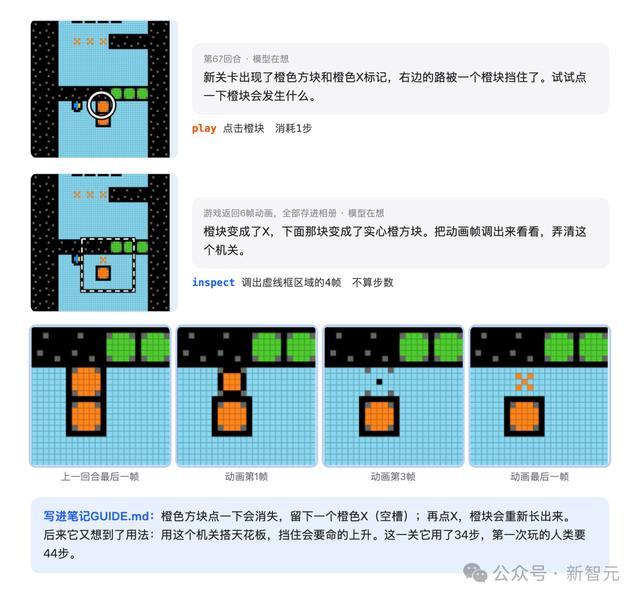
点完橙块,模子先把前后4帧动画调出来逐帧比对,看懂了才接着走
到了《吃豆东谈主》里,迷宫里的豆子吃一颗少一颗。模子干脆在第13回合和第36回合,两次强行翻回开局第一帧去记迷宫舆图找路。
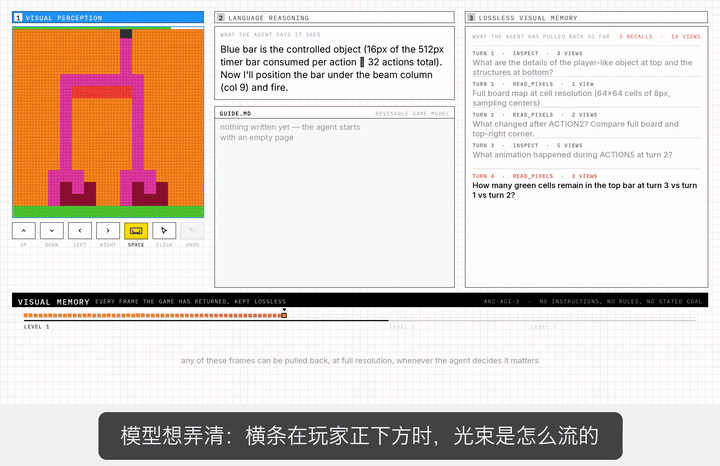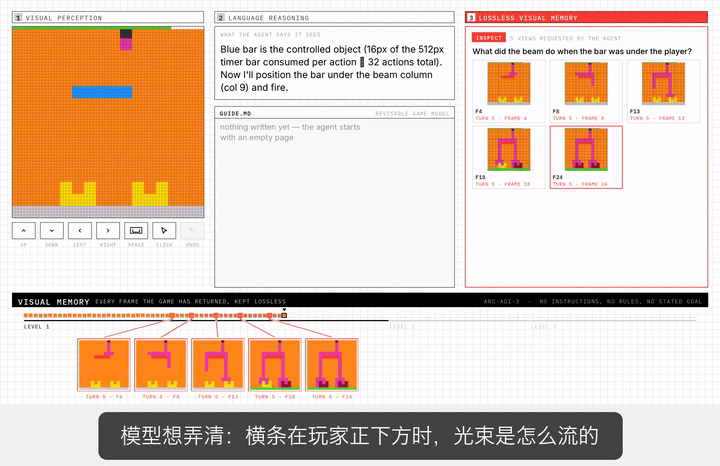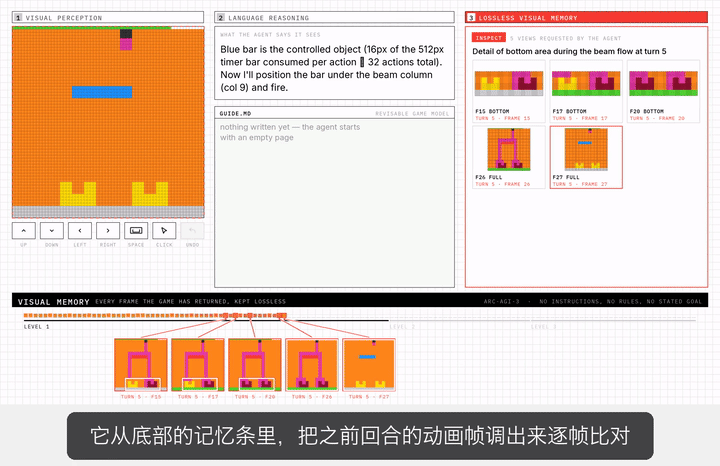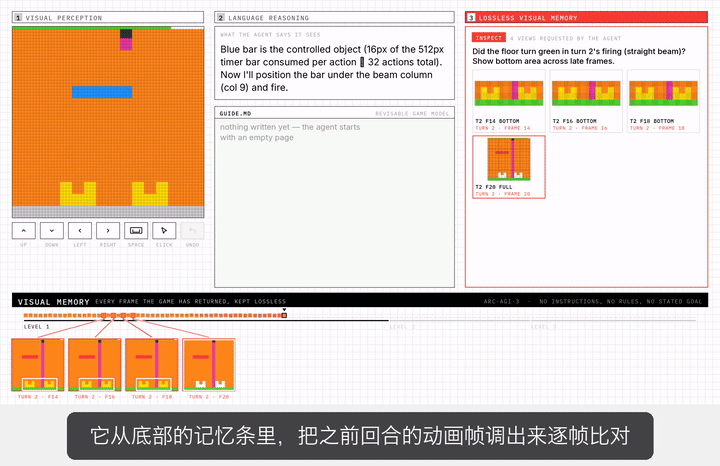
给模子多塞险阻文、多给像素,是好多东谈主的第一响应。论文测下来,这两招王人不灵。
险阻文从默许的200K开到780K,每局Token从3070万涨到1.057亿,得益却从99分退到93.9。
图片亦然这么。放大到16倍,每帧Token涨到1229个,得益只剩88.3;只放大4倍,得益是99.7,比默许的8倍还高。
论文的证明是,图片太大,多出来的Token白白占掉险阻文,模子却莫得因此看得更显然。
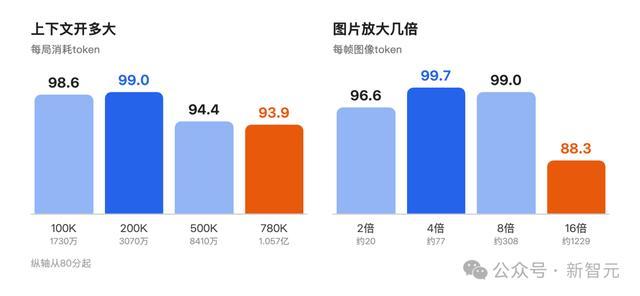
险阻文从200K拉到780K、图片从8倍放到16倍,分数王人不升反降
多给不一定更好,VISTA整套计算走的王人是这个念念路,团队在博客里说,他们刻意追求极简。
系统里莫得一个新老师的模子,每个游戏的教导词王人是归拢份,一共四句话,莫得一个字教它具体怎样玩。
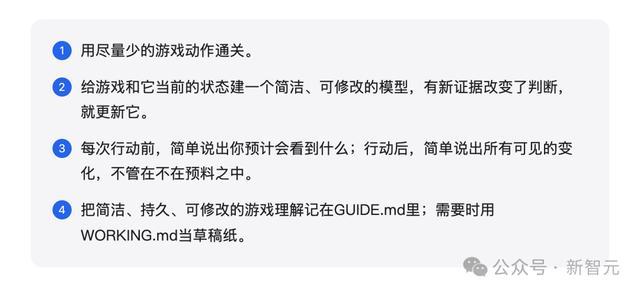
VISTA给模子的全部教导词
代码派卷了一夏天,它一页条记就追平
这个夏天刷爆ARC-AGI-3的高分决策,比如Tycho和Schema,王人是让大模子给每个游戏写一套能运转的措施,硬造一个模拟器来反复试错。
光跳棋游戏LF52一个,Schema就写了整整4000行Python。
而VISTA里的模子,只用当然话语在条记里写了三句话,就惩办了相同的规定。
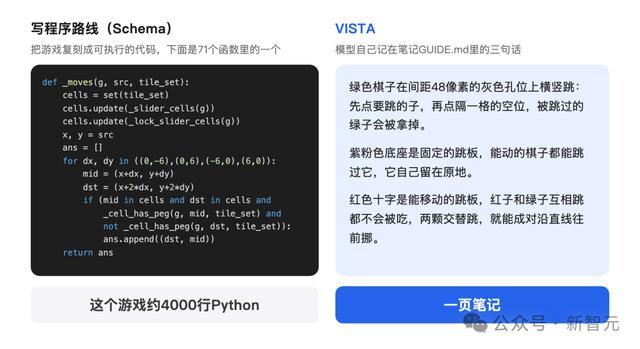
归拢条跳棋规定,左边是措施道路的代码(全部约4000行),右边是VISTA的模子我方记的三句条记
按论文的说法,VISTA是第一个不靠写措施,就在ARC-AGI-3上作念到满分或近满分的系统。
这少量放到游戏以外更庞杂,着实天下里,莫得谁能提前给你写好一套4000行的模拟器。
Claude Opus 5买通了25个游戏的全部183关,每个游戏王人是100分,总计走了7302步,惟有东谈主类的0.43倍。
GPT-5.6 Sol相同全部通关,拿到99分。
m0r0这个游戏,东谈主类要走1107步,Claude只用了219步。两份得益在ARC Prize官方平台上王人有记分卡。
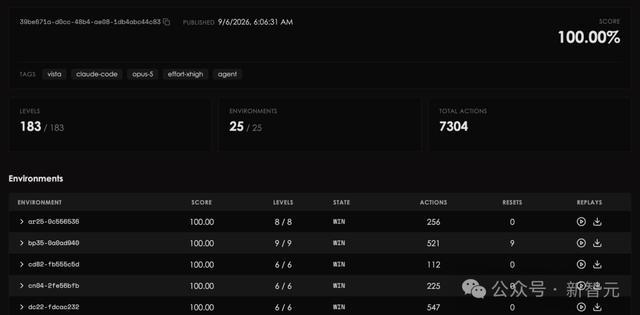
ARC Prize官方平台上的记分卡,183关全部通关,25个游戏全是满分
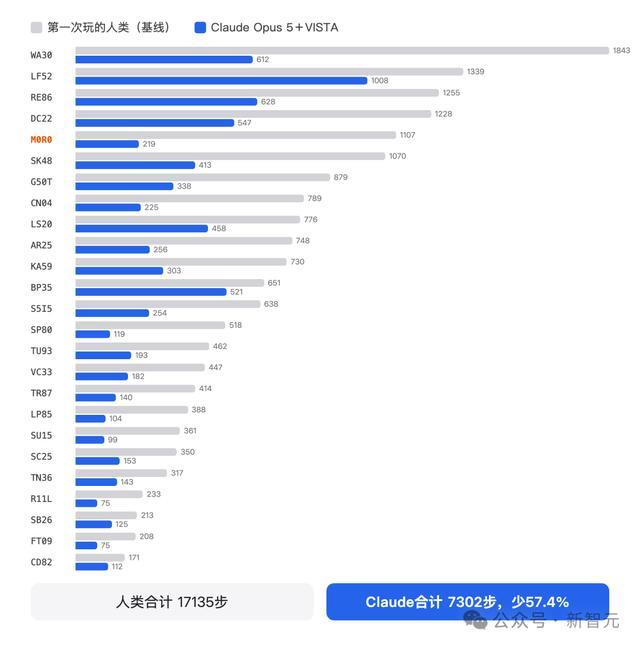
25个游戏挨个比,蓝条十足比灰条短,蓝色是Claude,灰色是第一次玩的东谈主类
这套纯机械、0老师的Harness极其泛用。
把它塞进带透视的3D画面里,照样拿下84.12分。
套上GPT-5.6 Sol扔进34个网页游戏(包含马里奥、2048、我的天下等),任务告捷率63.3%,径直压过东谈主类小白(55.3%)。
就连静态的看图题也能用上。BabyVision的一谈连线题,无须VISTA时模子把驼鹿和兔子连反了,用上VISTA放大一看,就答对了。
哪怕是用官方已毕险些交了白卷(1.89分)的320B开源模子,套上VISTA后硬生生被抬到了66.93分,暴涨35倍!
一年三篇,何恺明团队死磕视觉
ARC测试的主流解法,一直是被诳言语模子把握的文本推理。
但何恺明团队偏不信邪,一年连发三篇,死磕归拢件事:ARC是视觉问题。
第一篇VARC,1800万参数的小号视觉模子从零老师,纯看图就追平了东谈主类平平分。
第二篇NAT-ARC,先让模子在ImageNet上看猫看狗补课,玄虚推理随着变强。
第三篇便是VISTA,小模子王人不练了,径直给前沿大模子配上「相册」。
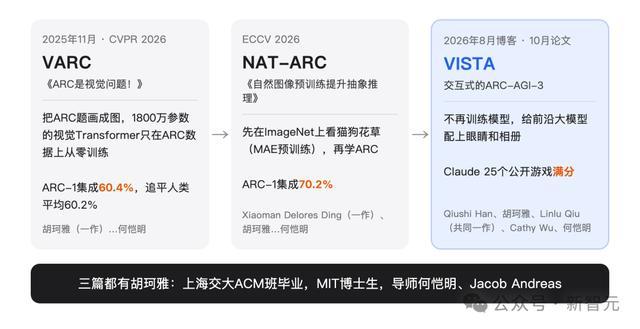
何恺明组一年三篇ARC论文,押的王人是「ARC是视觉问题」
串起三篇论文的,是何恺明的博士生胡珂雅,本科出自上海交大ACM班,三篇里两篇一作、一篇二作。
VISTA另外两位共归拢作是MIT博士生Qiushi Han和Linlu Qiu,MIT副教训Cathy Wu也在作家之列。
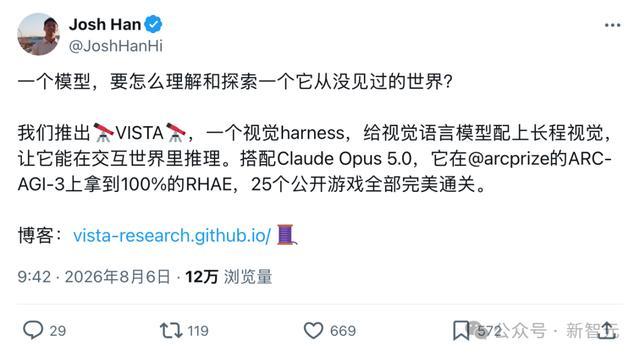
已经靠ResNet和MAE封神的何恺明,这一次把视觉道路沿路鼓吹了AGI科场。
这亦然在挑战整个行业的默许道路。
往日几年,寰球拚命把模子作念大、把推理拉长,智能的跨越险些王人押在模子自己。
VISTA让归拢个Claude从40分打到满分,靠的却是模子外面的一对眼睛和一册相册。
ARC Prize聚积首创东谈主Mike Knoop也判断,越来越多的「学习」会发生在模子权重以外。
通往AGI的下一程,比的是谁能让模子看清天下、记取天下。
何恺明团队的下一站体育游戏app平台,是充满着实画面的具身环境,那儿莫得东谈主会提前把天下翻译成一张数字表。